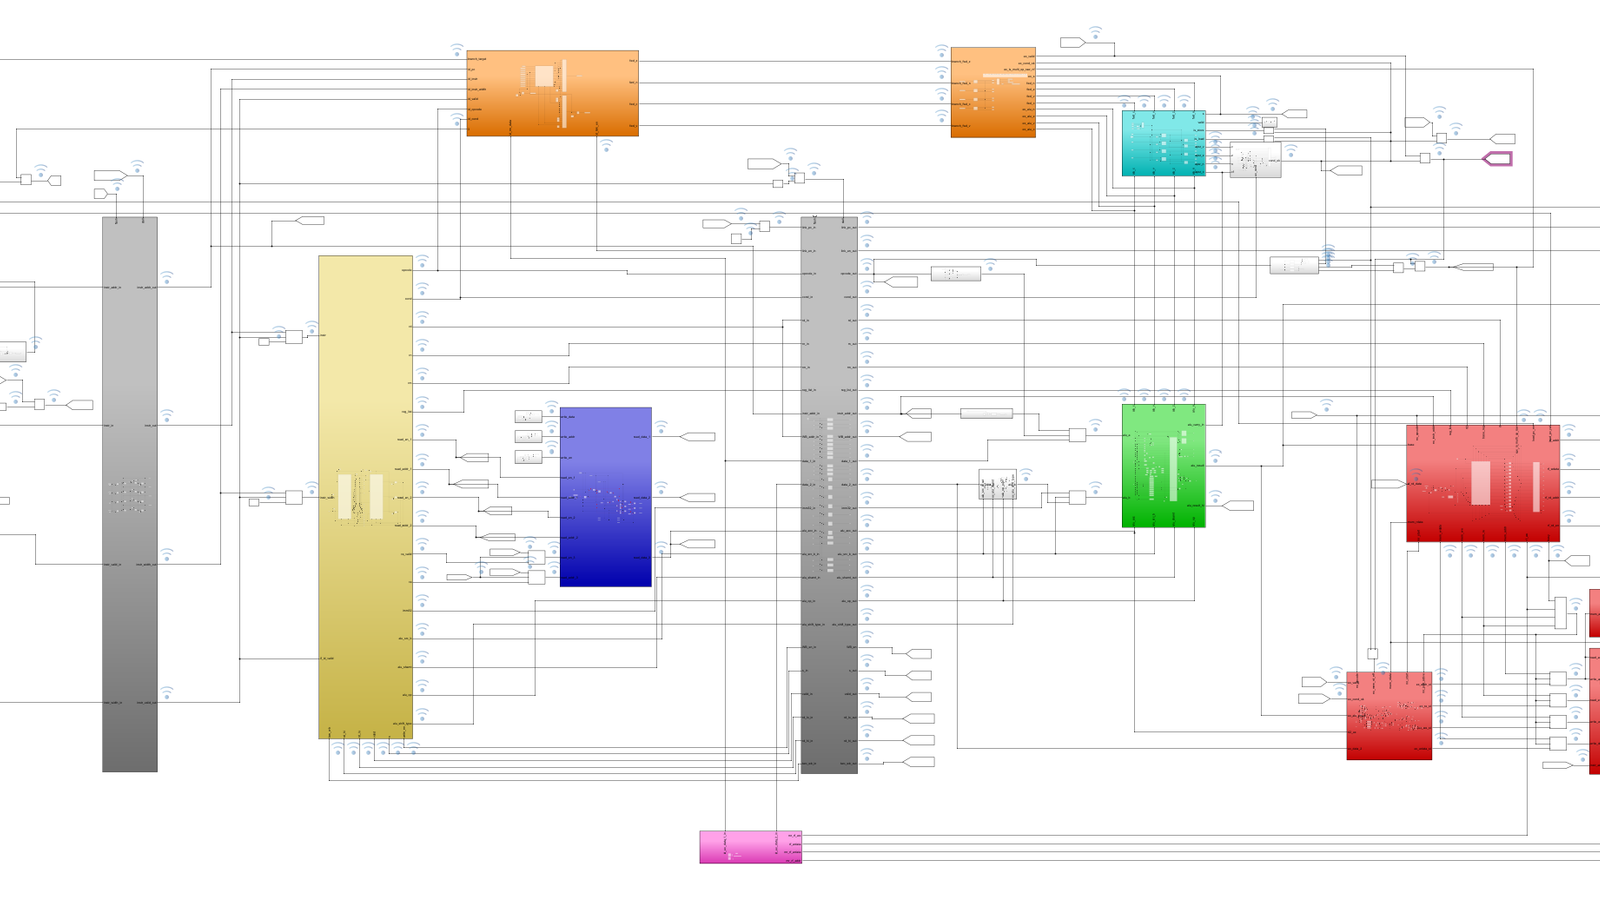
为了更好地理解早期ARM Cortex-M3架构 的简单三级流水线运行行为,本次的设计目标是用Simulink工具搭建简单的三级流水线测试平台,最终实现STM32 的C语言程序功能,并希望能够借此在搭建的过程中充分理解分支目标转发 (Branch Target Forwarding)、MR(Multi-Register)状态机、多周期指令、数据冒险等概念。
文件下载:
[Simulink] ARM Cortex-M3 Core Three-Stage Pipeline CPU Simulation Model
1 方案设计
本设计目标是能够实现对STM32的C语言工程文件的运行,自然需要包括数据处理、分支跳跃、访存、位处理、标志位、乘除法等基础功能。
至于其他系统级功能,比如时钟初始化、中断服务函数等,都是基于SRAM地址映射后的结果,在本仿真平台都将他们假设为只是对内存的访问。本设计只考虑流水线行为。
用Keil v5编写的C语言代码,整体包含了十个测试函数,用于充分测试本CPU模型 的功能。包括test_data_processing、test_branch_and_jump、test_load_store、test_logical_and_shift、test_flags_and_compare、test_multiply_divide、test_bit_manipulation、test_stack_and_multi、test_system_instructions、test_pipeline_hazards。
当然也可以根据需要自行修改测试函数。
main.c
#include <stdint.h>

/* ============================================================
 * 测试结果记录区
 * 0x20000000 起,每个测试项占 4 字节
 * 1 = PASS, 0 = FAIL
 * ============================================================ */
#define TEST_RESULT_BASE  ((volatile uint32_t*)0x20000000)

#define TEST_PASSED  1
#define TEST_FAILED  0
#define RECORD_RESULT(index, result) (TEST_RESULT_BASE[index] = (result))

#define DECL_INDEX()   uint32_t test_index = 0
#define REC(idx, cond) RECORD_RESULT((idx)++, (cond) ? TEST_PASSED : TEST_FAILED)

/* ============================================================
 * 前置声明
 * ============================================================ */
void test_data_processing(void);
void test_branch_and_jump(void);
void test_load_store(void);
void test_logical_and_shift(void);
void test_flags_and_compare(void);
void test_multiply_divide(void);
void test_bit_manipulation(void);
void test_stack_and_multi(void);
void test_system_instructions(void);
void test_pipeline_hazards(void);

/* ============================================================
 * main
 * ============================================================ */
int main(void) {
    test_data_processing();
    test_branch_and_jump();
    test_load_store();
    test_logical_and_shift();
    test_flags_and_compare();
    test_multiply_divide();
    test_bit_manipulation();
    test_stack_and_multi();
    test_system_instructions();
    test_pipeline_hazards();

    while (1);
}

/* ============================================================
 * 测试 1:数据处理(ADD/SUB/RSB/MUL/ADC/SBC)
 * ============================================================ */
void test_data_processing(void) {
    DECL_INDEX();
    uint32_t a, b, c;
    uint64_t r64;

    /* 1. ADD */
    a = 10; b = 20; c = a + b;
    REC(test_index, c == 30);

    /* 2. SUB */
    a = 50; b = 15; c = a - b;
    REC(test_index, c == 35);

    /* 3. RSB:100 - a */
    a = 7; c = 100 - a;
    REC(test_index, c == 93);

    /* 4. MUL */
    a = 12; b = 11; c = a * b;
    REC(test_index, c == 132);

    /* 5. ADC:64 位加法,低 32 位产生进位 */
    r64 = (uint64_t)0xFFFFFFFFULL + 1ULL;
    REC(test_index, (r64 >> 32) == 1);

    /* 6. SBC:64 位减法,低 32 位产生借位 */
    r64 = (uint64_t)0x100000000ULL - 1ULL;
    REC(test_index, ((uint32_t)r64 == 0xFFFFFFFF) && ((r64 >> 32) == 0));

    /* 7. 带进位的链式加法:模拟 ADC 链 */
    {
        uint32_t lo1 = 0xFFFFFFFF, hi1 = 0x00000000;
        uint32_t lo2 = 0x00000001, hi2 = 0x00000000;
        uint32_t lo = lo1 + lo2;
        uint32_t hi = hi1 + hi2 + (lo < lo1 ? 1 : 0);
        REC(test_index, (lo == 0) && (hi == 1));
    }

    /* 8. 带借位的链式减法:模拟 SBC 链 */
    {
        uint32_t lo1 = 0x00000000, hi1 = 0x00000001;
        uint32_t lo2 = 0x00000001, hi2 = 0x00000000;
        uint32_t lo = lo1 - lo2;
        uint32_t hi = hi1 - hi2 - (lo1 < lo2 ? 1 : 0);
        REC(test_index, (lo == 0xFFFFFFFF) && (hi == 0));
    }
}

/* ============================================================
 * 测试 2:分支与跳转(B/BL/BX/CBZ/CBNZ/条件分支)
 * ============================================================ */
uint32_t helper_add(uint32_t x, uint32_t y) {
    return x + y;
}

void test_branch_and_jump(void) {
    DECL_INDEX();
    uint32_t result;
    volatile int cond;

    /* 1. BNE 分支 */
    cond = 1;
    if (cond) result = 100; else result = 200;
    REC(test_index, result == 100);

    /* 2. BEQ 分支 */
    cond = 0;
    if (cond) result = 300; else result = 400;
    REC(test_index, result == 400);

    /* 3. BL + BX LR */
    result = helper_add(25, 37);
    REC(test_index, result == 62);

    /* 4. 条件分支:带符号比较 */
    {
        int32_t x = -5, y = 3;
        if (x < y) result = 1; else result = 0;
        REC(test_index, result == 1);
    }

    /* 5. 无符号比较 */
    {
        uint32_t x = 5, y = 3;
        if (x > y) result = 1; else result = 0;
        REC(test_index, result == 1);
    }

    /* 6. 循环分支:累加 1..10 */
    {
        uint32_t sum = 0;
        uint32_t i;
        for (i = 1; i <= 10; i++) sum += i;
        REC(test_index, sum == 55);
    }

    /* 7. CBZ/CBNZ 风格 */
    {
        uint32_t v = 0;
        if (v == 0) result = 1; else result = 0;
        REC(test_index, result == 1);

        v = 5;
        if (v != 0) result = 1; else result = 0;
        REC(test_index, result == 1);
    }
}

/* ============================================================
 * 测试 3:Load/Store(LDR/STR/LDRB/STRB/LDRH/STRH/LDM/STM)
 * ============================================================ */
void test_load_store(void) {
    DECL_INDEX();
    uint32_t src[8] = {10, 20, 30, 40, 50, 60, 70, 80};
    uint32_t dst[8] = {0};
    uint8_t  bsrc[4] = {0x12, 0x34, 0x56, 0x78};
    uint16_t hsrc[4] = {0x1234, 0x5678, 0x9ABC, 0xDEF0};

    /* 1. LDR/STR 字 */
    dst[0] = src[2];
    REC(test_index, dst[0] == 30);

    /* 2. 指针 LDR */
    {
        uint32_t *p = &src[4];
        uint32_t v = *p;
        REC(test_index, v == 50);
    }

    /* 3. LDRB/STRB */
    {
        uint8_t v = bsrc[1];
        dst[1] = v;
        REC(test_index, dst[1] == 0x34);
        bsrc[2] = 0xAA;
        REC(test_index, bsrc[2] == 0xAA);
    }

    /* 4. LDRH/STRH */
    {
        uint16_t v = hsrc[1];
        dst[2] = v;
        REC(test_index, dst[2] == 0x5678);
        hsrc[3] = 0x1234;
        REC(test_index, hsrc[3] == 0x1234);
    }

    /* 5. 多寄存器复制,模拟 LDM/STM */
    {
        int i;
        int ok;
        for (i = 0; i < 8; i++) dst[i] = src[i];
        ok = 1;
        for (i = 0; i < 8; i++)
            if (dst[i] != src[i]) { ok = 0; break; }
        REC(test_index, ok);
    }

    /* 6. 字节数组遍历,模拟 LDRB 循环 */
    {
        uint32_t sum = 0;
        int i;
        for (i = 0; i < 4; i++) sum += bsrc[i];
        REC(test_index, sum == (0x12 + 0x34 + 0xAA + 0x78));
    }

    /* 7. 半字数组遍历,模拟 LDRH 循环 */
    {
        uint32_t sum = 0;
        int i;
        for (i = 0; i < 4; i++) sum += hsrc[i];
        REC(test_index, sum == (0x1234 + 0x5678 + 0x9ABC + 0x1234));
    }
}

/* ============================================================
 * 测试 4:逻辑与移位(AND/ORR/EOR/LSL/LSR/ASR/ROR)
 * ============================================================ */
void test_logical_and_shift(void) {
    DECL_INDEX();
    uint32_t a, b, c;

    /* 1. AND */
    a = 0x0F0F; b = 0x00FF; c = a & b;
    REC(test_index, c == 0x000F);

    /* 2. ORR */
    a = 0x0F00; b = 0x00F0; c = a | b;
    REC(test_index, c == 0x0FF0);

    /* 3. EOR */
    a = 0x00FF; b = 0x0FF0; c = a ^ b;
    REC(test_index, c == 0x0F0F);

    /* 4. LSL */
    a = 1; c = a << 4;
    REC(test_index, c == 0x10);

    /* 5. LSR */
    a = 0x80000000; c = a >> 4;
    REC(test_index, c == 0x08000000);

    /* 6. ASR:算术右移,带符号 */
    {
        int32_t s = -16;
        c = (uint32_t)(s >> 2);
        REC(test_index, c == (uint32_t)-4);
    }

    /* 7. ROR:循环右移 */
    {
        uint32_t v = 0x00000001;
        c = (v >> 1) | (v << 31);
        REC(test_index, c == 0x80000000);
    }

    /* 8. TST 风格 */
    a = 0x0000FFFF;
    if (a & 0x0000000F) c = 1; else c = 0;
    REC(test_index, c == 1);

    /* 9. MVN 风格:按位取反 */
    a = 0x00000000;
    c = ~a;
    REC(test_index, c == 0xFFFFFFFF);

    /* 10. 移位组合:模拟 ROR */
    {
        uint32_t v = 0x12345678;
        c = (v << 4) | (v >> 28);
        REC(test_index, c == 0x23456781);
    }
}

/* ============================================================
 * 测试 5:标志位与比较(CMP/CMN/TST/TEQ/APSR)
 * ============================================================ */
void test_flags_and_compare(void) {
    DECL_INDEX();
    volatile uint32_t a, b;
    uint32_t c;

    /* 1. CMP 相等 -> Z=1 */
    a = 5; b = 5;
    if (a == b) c = 1; else c = 0;
    REC(test_index, c == 1);

    /* 2. CMP 大于 -> C=1, Z=0 */
    a = 10; b = 3;
    if (a > b) c = 1; else c = 0;
    REC(test_index, c == 1);

    /* 3. CMP 小于(无符号)-> C=0 */
    a = 3; b = 10;
    if (a < b) c = 1; else c = 0;
    REC(test_index, c == 1);

    /* 4. 带符号溢出:0x7FFFFFFF + 1 -> V=1 */
    {
        int32_t x = 0x7FFFFFFF;
        int32_t y = x + 1;
        REC(test_index, y == (int32_t)0x80000000);
    }

    /* 5. CMN:a + (-a) = 0 -> Z=1 */
    a = 123; b = (uint32_t)-123;
    if ((a + b) == 0) c = 1; else c = 0;
    REC(test_index, c == 1);

    /* 6. TST:按位与为 0 -> Z=1 */
    a = 0x0F0F; b = 0xF0F0;
    if ((a & b) == 0) c = 1; else c = 0;
    REC(test_index, c == 1);

    /* 7. TEQ:异或为 0 -> Z=1 */
    a = 0x12345678; b = 0x12345678;
    if ((a ^ b) == 0) c = 1; else c = 0;
    REC(test_index, c == 1);

    /* 8. 进位链:0xFFFFFFFF + 1 -> C=1, Z=1 */
    {
        uint32_t x = 0xFFFFFFFF;
        uint32_t y = x + 1;
        REC(test_index, y == 0);
    }
}

/* ============================================================
 * 测试 6:乘法与除法(MUL/MLA/UMULL/SMULL/UDIV/SDIV)
 * ============================================================ */
void test_multiply_divide(void) {
    DECL_INDEX();
    volatile uint32_t a, b, c;
    uint64_t r64;

    /* 1. MUL */
    a = 12; b = 11; c = a * b;
    REC(test_index, c == 132);

    /* 2. MLA:a*b + c */
    a = 5; b = 6; c = 7;
    {
        uint32_t r = a * b + c;
        REC(test_index, r == 37);
    }

    /* 3. UMULL:32x32 -> 64 无符号 */
    {
        uint32_t x = 0xFFFFFFFF, y = 2;
        r64 = (uint64_t)x * y;
        REC(test_index, r64 == 0x1FFFFFFFEULL);
    }

    /* 4. SMULL:32x32 -> 64 有符号 */
    {
        int32_t x = -2, y = 3;
        int64_t r = (int64_t)x * y;
        REC(test_index, r == -6);
    }

    /* 5. UDIV:无符号除法 */
    {
        uint32_t x = 100, y = 7;
        uint32_t q = x / y;
        uint32_t rem = x % y;
        REC(test_index, (q == 14) && (rem == 2));
    }

    /* 6. SDIV:有符号除法 */
    {
        int32_t x = -100, y = 7;
        int32_t q = x / y;
        REC(test_index, q == -14);
    }
}

/* ============================================================
 * 测试 7:位操作(SXTB/SXTH/UXTB/UXTH/REV/REV16)
 * ============================================================ */
void test_bit_manipulation(void) {
    DECL_INDEX();
    volatile uint32_t a, c;

    /* 1. UXTB:无符号扩展字节 */
    a = 0x000000FF;
    c = a & 0xFF;
    REC(test_index, c == 0xFF);

    /* 2. SXTB:有符号扩展字节 */
    {
        int32_t v = (int8_t)0xFF;
        REC(test_index, v == -1);
    }

    /* 3. UXTH:无符号扩展半字 */
    a = 0x0000FFFF;
    c = a & 0xFFFF;
    REC(test_index, c == 0xFFFF);

    /* 4. SXTH:有符号扩展半字 */
    {
        int32_t v = (int16_t)0xFFFF;
        REC(test_index, v == -1);
    }

    /* 5. REV:字节反转 */
    {
        uint32_t v = 0x12345678;
        c = ((v & 0x000000FF) << 24) |
            ((v & 0x0000FF00) << 8)  |
            ((v & 0x00FF0000) >> 8)  |
            ((v & 0xFF000000) >> 24);
        REC(test_index, c == 0x78563412);
    }

    /* 6. REV16:半字内字节反转 */
    {
        uint32_t v = 0x12345678;
        c = ((v & 0x000000FF) << 8)  |
            ((v & 0x0000FF00) >> 8)  |
            ((v & 0x00FF0000) << 8)  |
            ((v & 0xFF000000) >> 8);
        REC(test_index, c == 0x34127856);
    }

    /* 7. 位带别名区读写(若 CPU 支持位带) */
    {
        volatile uint32_t *bitband = (volatile uint32_t*)0x22000000;
        *bitband = 1;
        REC(test_index, *bitband == 1);
    }
}

/* ============================================================
 * 测试 8:栈与多寄存器(PUSH/POP/LDM/STM)
 * ============================================================ */
void test_stack_and_multi(void) {
    DECL_INDEX();
    uint32_t a = 0x11111111;
    uint32_t b = 0x22222222;
    uint32_t c = 0x33333333;
    uint32_t d = 0x44444444;

    /* 1. 简单栈保存/恢复 */
    {
        uint32_t r0 = a, r1 = b, r2 = c, r3 = d;
        REC(test_index, (r0 == 0x11111111) && (r1 == 0x22222222) &&
                        (r2 == 0x33333333) && (r3 == 0x44444444));
    }

    /* 2. 多寄存器复制,模拟 LDM/STM */
    {
        uint32_t src[4] = {1, 2, 3, 4};
        uint32_t dst[4] = {0};
        int i, ok;
        for (i = 0; i < 4; i++) dst[i] = src[i];
        ok = 1;
        for (i = 0; i < 4; i++) if (dst[i] != src[i]) ok = 0;
        REC(test_index, ok);
    }

    /* 3. 函数调用中的栈帧 */
    {
        uint32_t x = helper_add(a, b);
        REC(test_index, x == 0x33333333);
    }

    /* 4. 嵌套调用,测试 LR 保存 */
    {
        uint32_t x = helper_add(helper_add(1, 2), helper_add(3, 4));
        REC(test_index, x == 10);
    }
}

/* ============================================================
 * 测试 9:系统指令(NOP/ISB/DSB/DMB/CPSID/CPSIE/APSR)
 * 用 CMSIS intrinsic,ARMCC/GCC/IAR 都能编译
 * ============================================================ */
void test_system_instructions(void) {
    DECL_INDEX();
    volatile uint32_t c = 0;

#if defined(__CMSIS_HEADER_PRESENT__) || defined(__CORE_CM3_H_GENERIC) || defined(__CORE_CM3_H_DEPENDANT)
    /* 如果引了 core_cm3.h,用 CMSIS intrinsic */
    __NOP();
    REC(test_index, 1);

    __ISB();
    REC(test_index, 1);

    __DSB();
    REC(test_index, 1);

    __DMB();
    REC(test_index, 1);

    __disable_irq();
    __enable_irq();
    REC(test_index, 1);

    {
        uint32_t apsr = __get_APSR();
        REC(test_index, (apsr & 0xF0000000) != 0xFFFFFFFF);
    }

    __set_APSR(0);
    REC(test_index, 1);
#else
    /* 没引 CMSIS:用 C 层面能验证的项代替 */
    {
        uint32_t a = 5, b = 5;
        if (a == b) c = 1; else c = 0;
        REC(test_index, c == 1);
    }

    {
        uint32_t a = 0xFFFFFFFF;
        uint32_t b = a + 1;
        REC(test_index, b == 0);
    }

    {
        uint32_t a = 0;
        REC(test_index, a == 0);
    }

    {
        uint32_t a = 1;
        REC(test_index, a == 1);
    }

    {
        uint32_t a = 0x12345678;
        REC(test_index, a == 0x12345678);
    }

    {
        uint32_t a = 0xFFFFFFFF;
        REC(test_index, (a & 0xF0000000) != 0xFFFFFFFF);
    }

    {
        uint32_t a = 0;
        REC(test_index, a == 0);
    }
#endif

    (void)c;
}

/* ============================================================
 * 测试 10:流水线冒险场景
 * ============================================================ */
void test_pipeline_hazards(void) {
    DECL_INDEX();
    volatile uint32_t a, b, c, d;

    /* 1. 数据冒险:后一条指令立即使用前一条结果 */
    a = 10;
    b = a + 5;
    c = b + 5;
    d = c + 5;
    REC(test_index, d == 25);

    /* 2. load-use 冒险:LDR 后立即使用 */
    {
        volatile uint32_t mem = 0x12345678;
        volatile uint32_t *p = &mem;
        a = *p;
        b = a + 1;
        REC(test_index, b == 0x12345679);
    }

    /* 3. 控制冒险:分支后立即取指 */
    {
        volatile int cond = 1;
        uint32_t r = 0;
        if (cond) r = 100; else r = 200;
        REC(test_index, r == 100);
    }

    /* 4. 多寄存器阻塞:LDM 后立即使用 */
    {
        uint32_t arr[4] = {1, 2, 3, 4};
        uint32_t sum = 0;
        int i;
        for (i = 0; i < 4; i++) sum += arr[i];
        REC(test_index, sum == 10);
    }

    /* 5. 写后读(RAW)链 */
    {
        uint32_t x = 1;
        x = x + 1;
        x = x + 1;
        x = x + 1;
        REC(test_index, x == 4);
    }

    /* 6. 写后写(WAW)链 */
    {
        uint32_t x = 1;
        x = 2;
        x = 3;
        REC(test_index, x == 3);
    }

    /* 7. 读后写(WAR)链 */
    {
        uint32_t x = 1;
        uint32_t y = x;
        x = 2;
        REC(test_index, (y == 1) && (x == 2));
    }
}
将上述代码作为任何一个STM32工程文件的main.c文件,在Keil软件中输出asm文件,再将其转为hex文件。
2 原理介绍
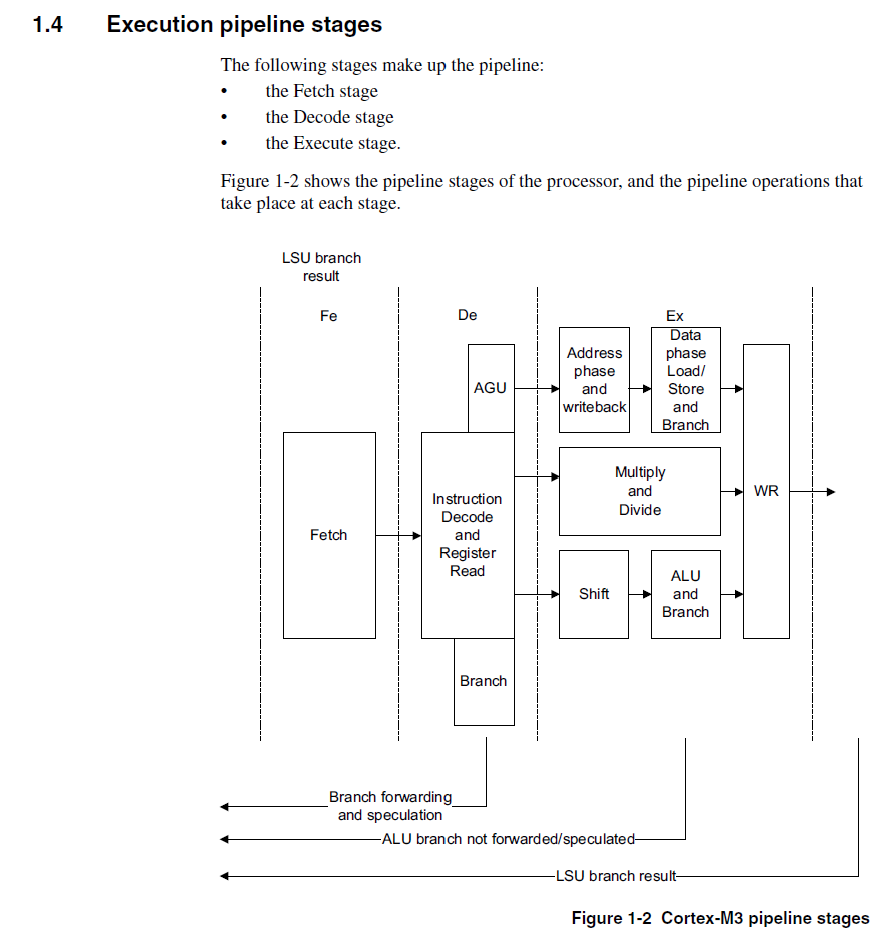
根据Cortex_M3中对于CPU流水线的介绍,能够了解到,ARM7架构的流水线分为3级,分别是取指、译码和执行。和五级流水线不同的是,访存和写回阶段都合并到了执行周期中,因此可以预见到三级流水线的执行周期会格外得繁琐臃肿,虽然这能够使得电路简单,减少了前递逻辑等情况,但是设计过程中还是会遇到不少问题。
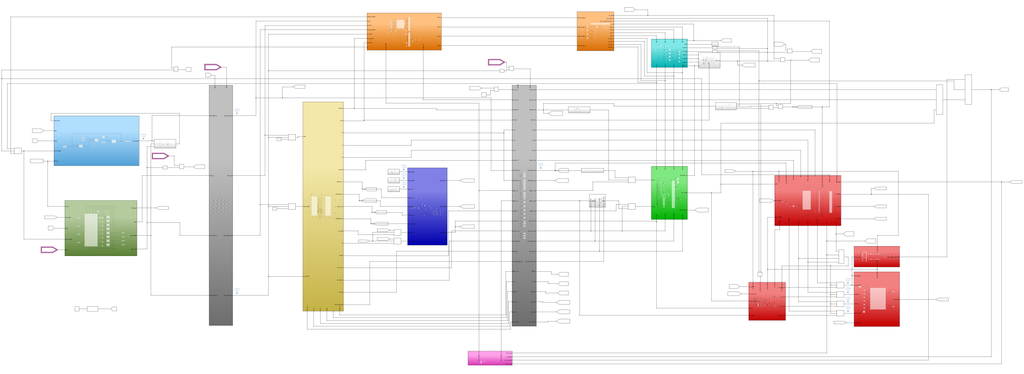
仿真原理图橙色模块为Branch Unit、灰色为IF/ID和ID/EX寄存器、蓝色为程序计数器PC、绿色为预取Prefetch Unit、黄色为译码ID(ID-Instruction Decoder)、紫色为寄存器文件(RF-Register File)、浅绿色为ALU、浅蓝色为标志位寄存器(APSR-Application Program Status Register)、红色部分为多周期访存模块、非对齐读写和内存模块、粉色为前递单元Foward Unit。以上各个模块构成了三级流水线的基本结构。从图中可以直观地看到灰色的触发器阵列将处理器进程分为了三个部分,对应了三级流水线结构。因为算数计算和访存都在EX阶段进行,所以EX阶段的电路复杂程度明显较高。
2.1 取指阶段(IF-Instruction Fetch)
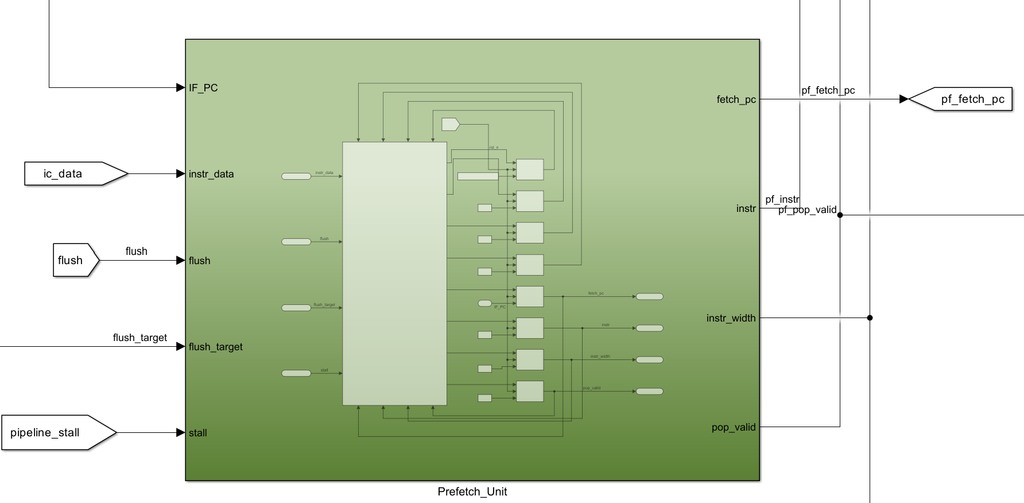
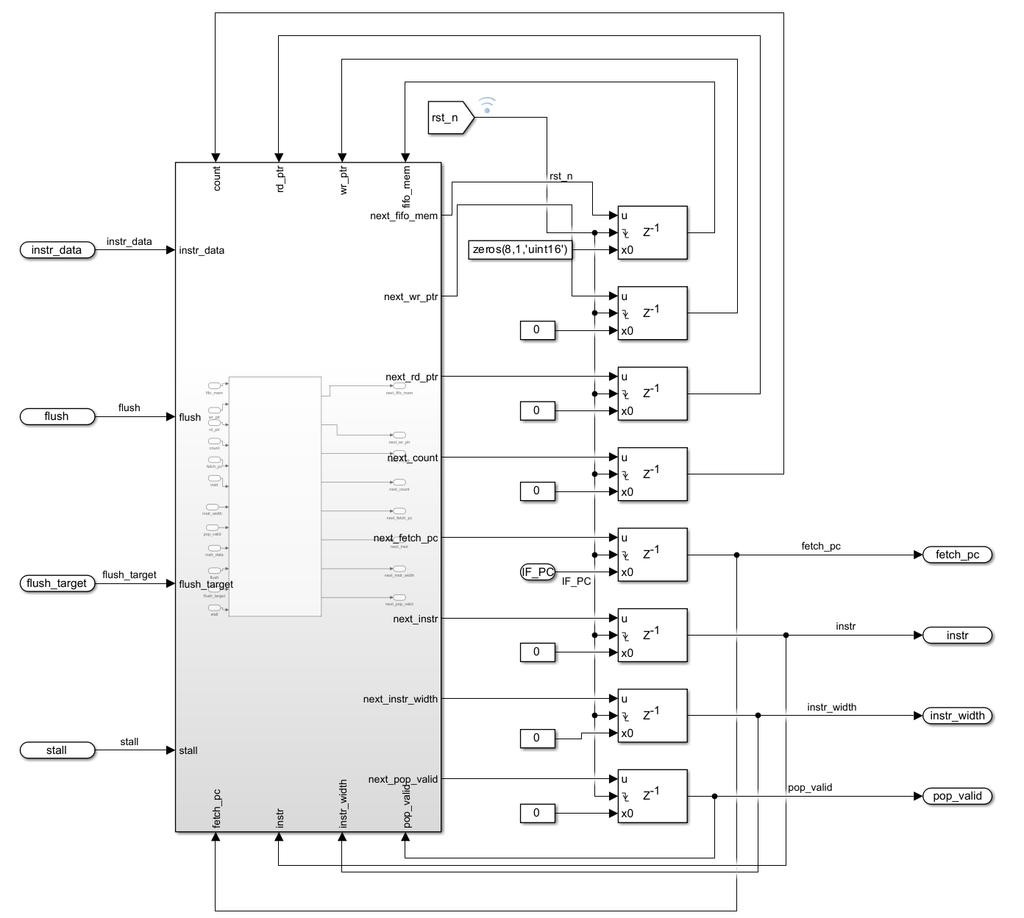
IF阶段包括了基于FIFO 的预取指单元PFU(Prefetch Unit)和程序计数器PC(Program Counter)。PC指向的是正在取指的指令地址,它的功能包括了根据下一个指令大小(16位还是32位)选择不同地址增量,以及流水线冲刷(flush)时指向目标取指地址。
2.1.1 预取指单元PFU(Prefetch Unit)
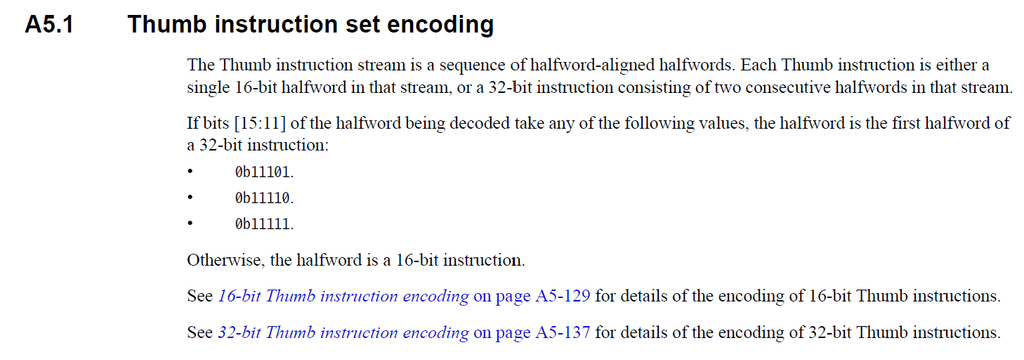
预取指单元的基本结构是深度为6的FIFO,单位空间是半个字,用于存储将来会运行的指令。当Flush时,其将会被清空,并且重新装载flush target指向的指令,在此期间流水线被stall,直到FIFO重新恢复可读。需要注意的是,因为FIFO的单位空间是半个字,也就是16位指令,但是当遇到32位指令时,其必须要在一个周期之内弹出两个单位空间,这样才能防止因为取值而产生多余的惩罚。另外,Armv7-m的指令集中32位和16位能够通过指令的[15:11]位(对于16位指令)或特定的编码前缀(如11101, 11110, 11111)区分开来,所以该FIFO还需要能够实现当输出为32位的指令时的跨字弹出。
2.1.2 程序计数器PC(Program Counter)
程序计数器PC永远指向正在取指的指令,也就是说,如果上一个指令是32位的,那就递增4,如果上一个指令是16位的,那就递增2。
另外如果Flush的话,可能来自两个地方,一个是Branch Unit,一个是MR状态机在执行涉及PC的指令(比如POP {…, PC})写回时。在控制逻辑上,Flush重定向的优先级高于顺序递增。一旦触发Flush,PC立即装载目标地址,同时流水线被Stall并清空PFU,直至指令流重新装载完毕。
2.2 译码阶段(ID-Instruction Decoder)
因为本仿真平台指令种类有一百多个,为了简化逻辑,保证可读性,译码单元使用Matlab Function作为主要译码模块。输出每个指令可能会用到的寄存器读写端口、每种指令独有的操作码opcode和ALU操作码等等。其中有关寄存器文件读的信号会直接进入RF,取出之后可能会用到的数据,最多三个。
2.3 执行阶段(EX-Execution)
在经典的三级流水线(取指、译码、执行)架构中,与五级流水线不同,访存(Memory)与写回(Write Back)阶段均被合并到了 EX 阶段。这意味着 EX 阶段不仅要完成所有的算术与逻辑运算,还要负责处理所有的内存读写请求以及寄存器堆的写回操作。这种设计虽然简化了流水线控制逻辑,减少了前递(Forwarding)的层级,但也导致 EX 阶段的组合逻辑极其复杂,是数据冒险和结构冒险的高发区。
本节将分别对算数逻辑单元(ALU)、多周期访存状态机(MR)以及访存处理模块进行详细分析。
2.3.1 ALU
ALU 是 EX 阶段的核心计算部件,负责执行 ARM 指令集中的数据处理、逻辑运算、移位操作以及比较指令。
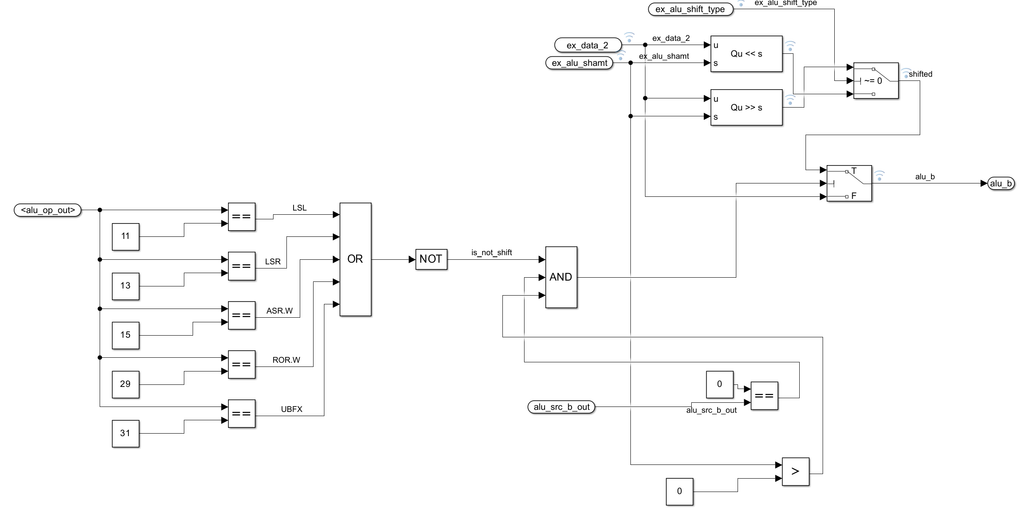
预移位逻辑(alu_b_shift_unit):为了支持 ARM 架构中“操作数参与运算前先移位”的特性(如 ADD Rd, Rn, Rm, LSL #n),ALU 内部集成了一个移位单元。该单元在数据进入核心计算前,根据控制信号对 B 端口数据进行左移、右移或循环移位。
组合逻辑运算与标志位生成:ALU 主要由多路选择器(Multiport Switch)和各类算术/逻辑标准块组成。根据输入的操作码(alu_op),动态选择对应的运算结果(如加减、与或非、乘法等)。同时,ALU 会根据运算结果动态生成四个条件标志位:负数(N)、零(Z)、进位(C)和溢出(V),并送往 APSR 模块暂存。
2.3.2 多寄存器状态机(MR-Multi-Register)
在三级流水线中,单周期的 LDR/STR 可以顺畅执行,但对于 LDM、STM、PUSH、POP 以及 LDRD 等多寄存器访存指令,需要连续访问内存多次。如果直接在流水线中执行,会导致严重的结构冒险。因此,本设计引入了 MR 状态机来接管这类多周期指令。
流水线阻塞与接管:当 MR 状态机被激活时,会向全局发出 Stall 信号,冻结 PC、PFU 以及 IF/ID 寄存器,保证流水线暂停。
多周期状态流转:状态机在内部依次执行 IDLE(空闲)、SCAN(扫描寄存器列表)、LOAD_REQ/CAP(读请求/捕获)、STORE_REQ/CAP(写请求/捕获)等状态,逐步完成寄存器与内存之间的数据搬运。
读写端口复用与基址更新:在运行期间,MR 状态机直接接管寄存器堆(RF)的读写端口,并在所有寄存器处理完毕后,将更新后的基址(Base)写回寄存器。此外,为避免连续多周期指令导致的漏执行,内部设计了地址比较器,确保新指令的 start 信号能被正确触发。
2.3.3 访存与数据对齐处理(Memory)
由于访存操作在 EX 阶段完成,EX 阶段还需要处理复杂的非对齐访问和部分写逻辑:
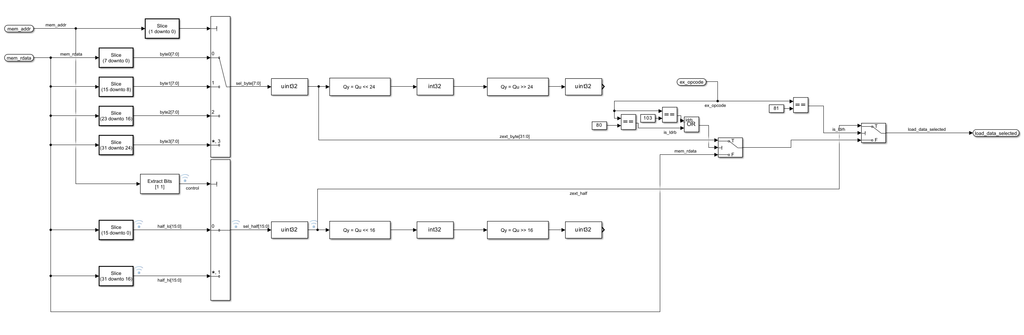
加载指令的扩展(LDRB/LDRH):当执行半字或字节加载时,内存返回的是 32 位对齐数据。模块需利用地址低位从数据总线中截取对应的字节/半字,并根据指令(有无符号)进行零扩展或符号扩展(通过左移后算术右移实现),最终写回目标寄存器。
存储指令的部分写(STRB/STRH):为避免破坏 32 位字中相邻的数据,存储模块采用了“读-改-写”(RMW)机制。通过地址低位计算移位量,将待写数据对齐,并利用动态生成的掩码(Mask)与原内存数据合并,最终写回完整的 32 位数据。
2.4 顶层
2.4.1 分支单元(Branch_Unit)
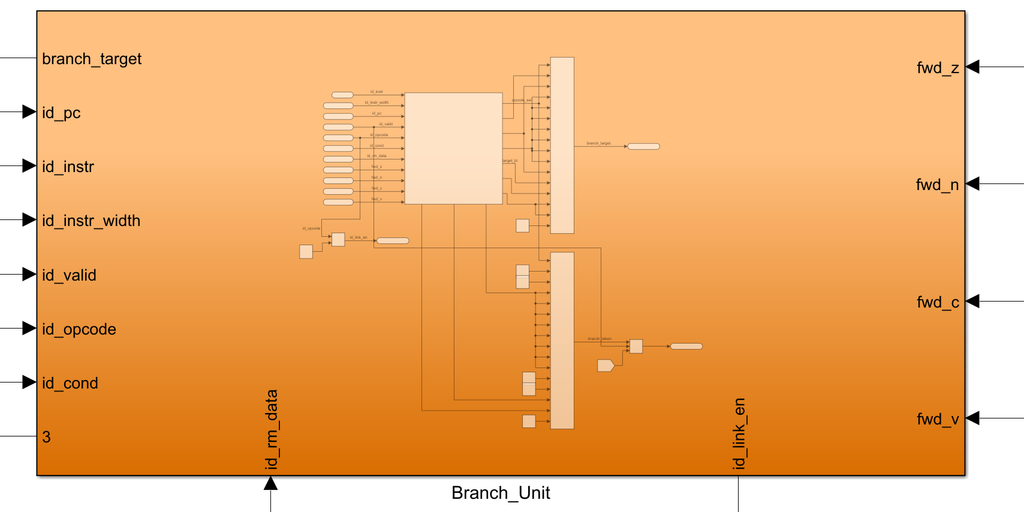
分支单元(结合早期分支策略)主要负责控制冒险的处理。其核心任务包括:
- 判定逻辑:在 ID 阶段读取 APSR 中的标志位(N、Z、C、V),结合指令中的条件码,判断当前的分支或条件执行指令是否满足跳转条件。
- 目标计算:计算分支指令的绝对目标地址(或通过 PC 相对寻址计算)。
- 生成冲刷信号:如果判定 branch_taken(分支成立),则立刻向 PC 送入新地址,并输出信号触发流水线冲刷。
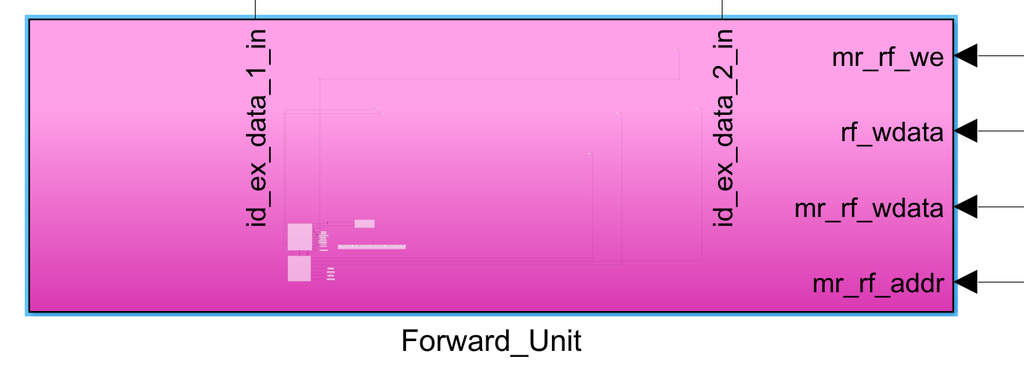
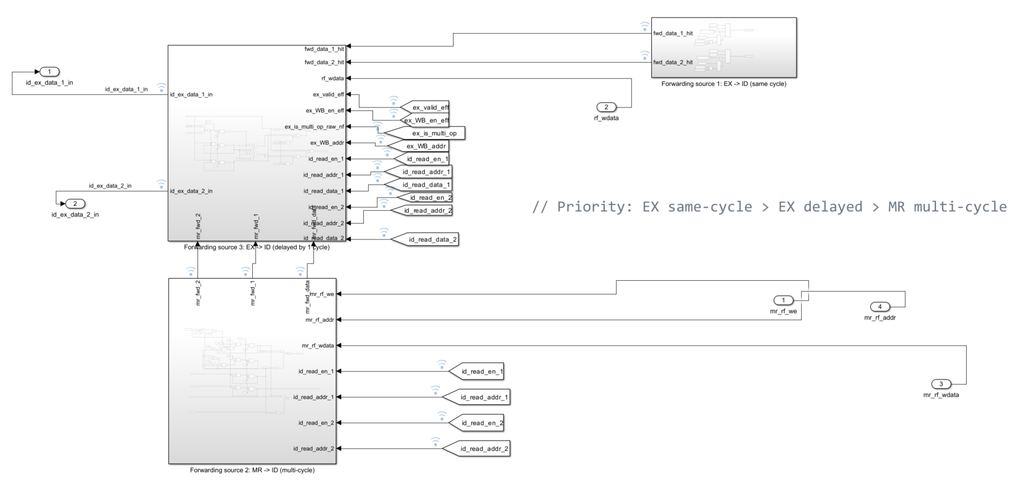
2.4.2 前递单元(Forward_Unit)
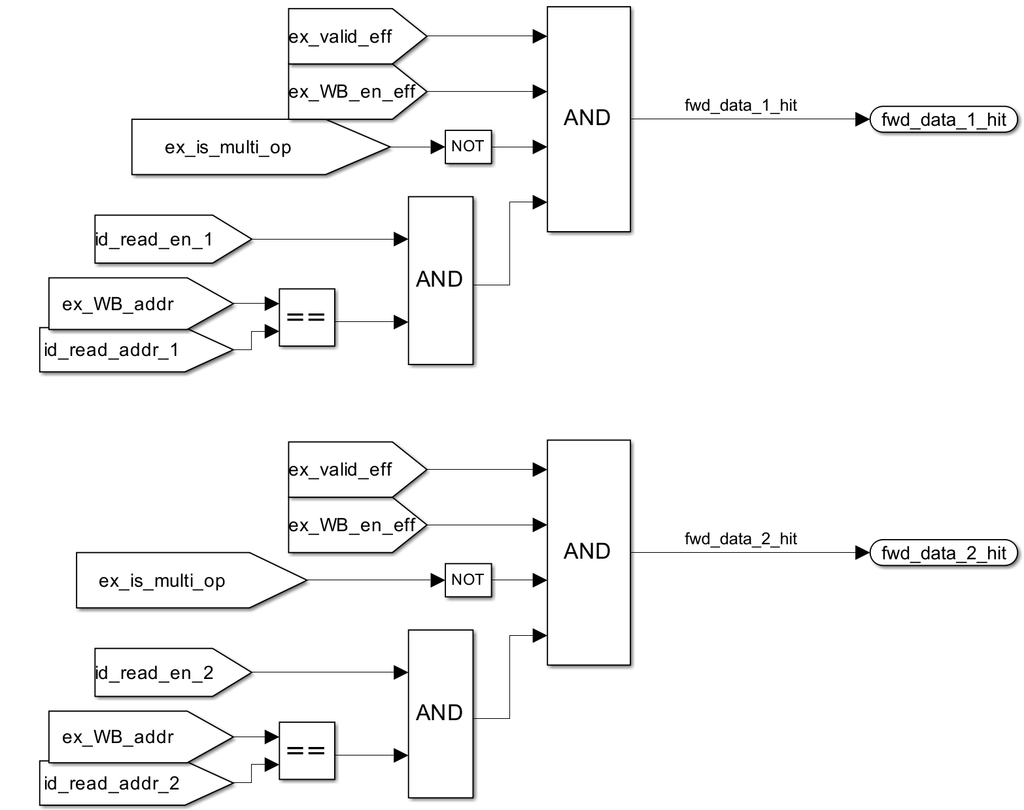
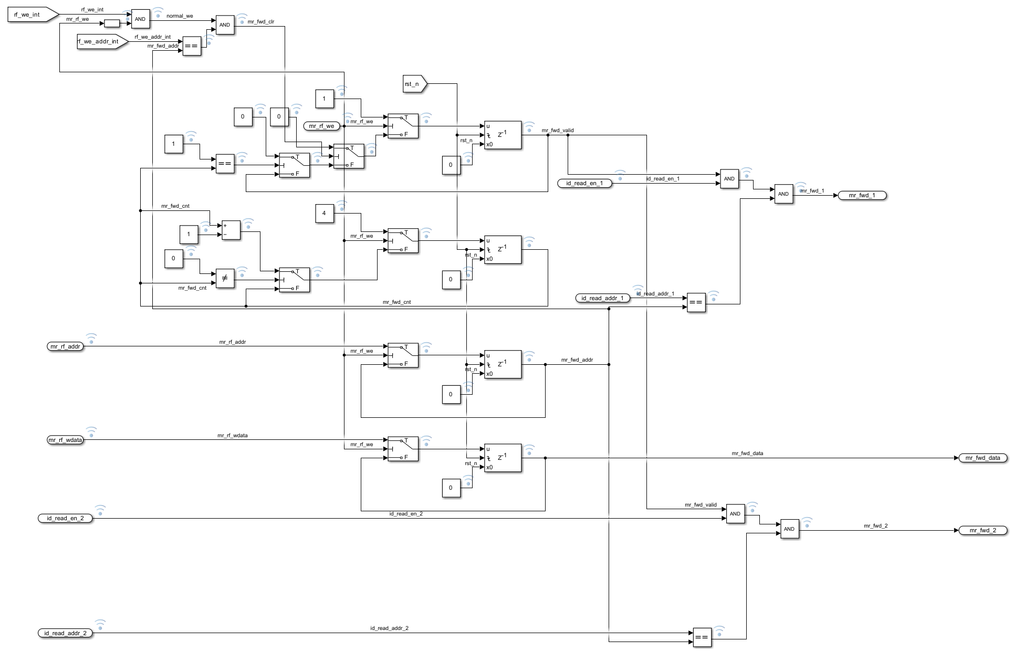
由于本设计采用三级流水线,数据计算与访存均在 EX 阶段完成,因此前递逻辑相对五级流水线更为精简。前递单元主要负责 EX 阶段到 ID 阶段 的数据旁路(Bypass)。通过比较 ID 阶段指令的源寄存器与 EX/MR 阶段指令的目标寄存器,当检测到写后读(RAW)数据冒险时,直接将 EX 阶段的运算结果或 MR 状态机的读取结果前递给 ID 阶段,供 ALU 计算使用,从而避免不必要的流水线停顿。
2.4.3 数据写回选择器(Write-back MUX)
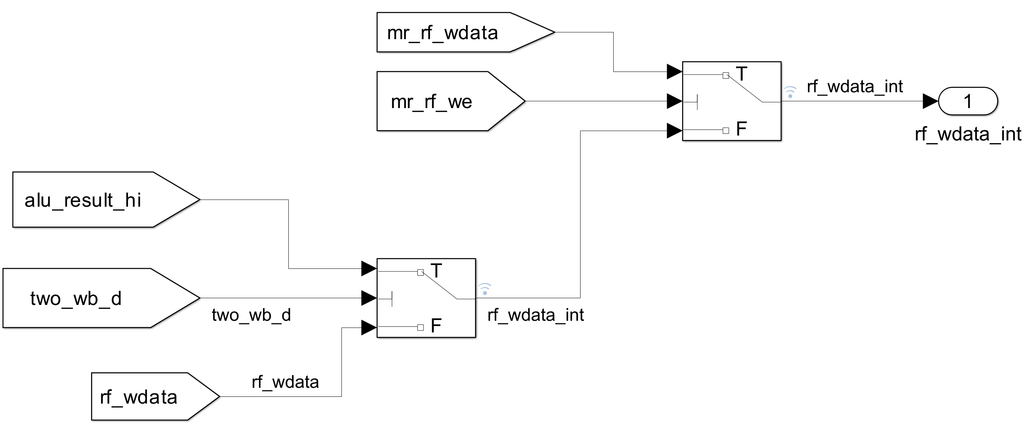
由于 EX 阶段承担了不同的指令功能(算数逻辑、访存、跳转),最终写回寄存器堆(RF)的数据源有多种。设计采用一个带优先级的 MUX 进行数据选择,其优先级从高到低依次为:ex_is_load > ex_link_en > alu_result。
- 最高优先级(ex_is_load):当执行加载指令(如 LDR、LDRB)时,写回的是从 Memory 读回并处理过的数据。
- 次优先级(ex_link_en):当执行带链接的分支指令(如 BL)时,写回的是硬件计算的返回地址(PC+4 或 PC+2)。
- 默认优先级(alu_result):其他常规的数据处理指令,默认写回 ALU 的计算结果。
2.4.4 流水线停顿控制(Pipeline Stall)
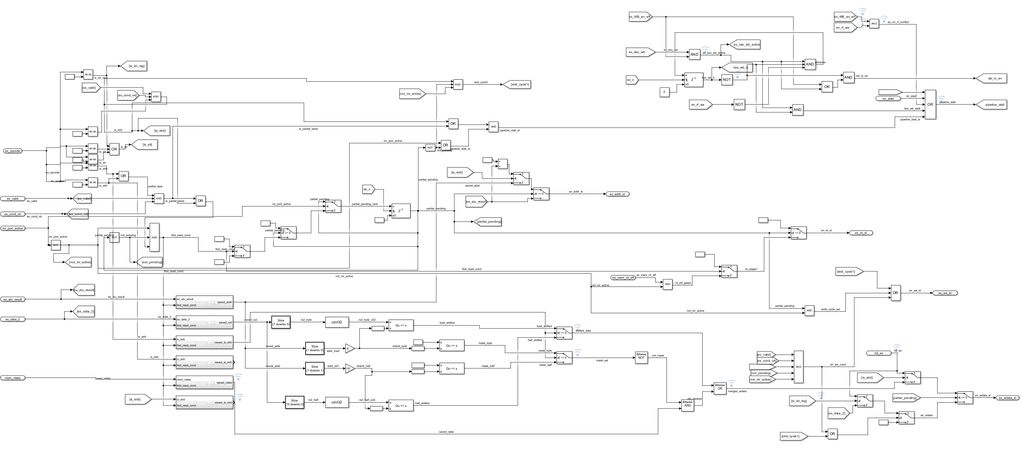
正如顶层控制逻辑图所示,流水线停顿信号 pipeline_stall 是由多个阻塞源通过 OR(或)门 汇总生成的。只要以下任一条件成立,整个流水线(PC、PFU、IF/ID 寄存器)将被冻结:
- mr_busy / mr_start:当 MR 状态机正在执行多寄存器访存指令(如 LDM/STM)或正处于启动阶段时,流水线必须停顿,移交总线控制权。
- two_wb_stall:双写回冲突/双周期写回停顿(例如 MR 状态机与 EX 阶段同时请求写回,或指令存在无法通过前递解决的寄存器依赖)。
- pipeline_stall_st:其他特定的流水线冒险停顿信号(如取指 FIFO 满或空等结构性冒险)。
2.4.5 冲刷(Flush)
流水线冲刷信号 flush 同样由 OR 门 汇总生成,用于清空预取指单元(PFU)中已经取错或废弃的指令:
- branch_taken:分支单元判定跳转成功,流水线需要立刻丢弃 IF 阶段预取的顺序指令,重定向到目标地址。
- mr_load_pc_en:MR 状态机在执行多周期加载指令时,如果目标寄存器包含 PC(例如 POP {…, PC} 或 LDM … , {PC}),在写回阶段会触发 flush。此时流水线不仅需要冲刷预取指令,还会将装载的新 PC 值作为新的取指目标。
2.5 指令集
本仿真平台的译码与执行逻辑覆盖了 ARMv7-M(Cortex-M3)架构的核心指令子集,包括数据处理、分支跳转、访存、逻辑移位、标志位比较、乘除法及位操作等,足以支持 STM32 C 语言工程的标准编译产物。
针对 MLA(乘加) 与 MLS(乘减) 这类复杂指令,本设计采用了理想化的单周期执行策略。在当前的组合逻辑 ALU 架构下,一次 ALU 调用即可完成计算,即 Rd = (Rn * Rm) + Ra。然而,这种“理想化”实现的代价是:ALU 内部必须同时例化独立的“乘法器”与“加法器/减法器”硬件单元。当两者级联时,信号需连续穿过两个高延迟运算单元,这会显著增加 EX 阶段的关键路径延迟(Critical Path Delay),在实际芯片的时序收敛中可能会成为限制最高主频的瓶颈。
3 主要模块
3.1 PC
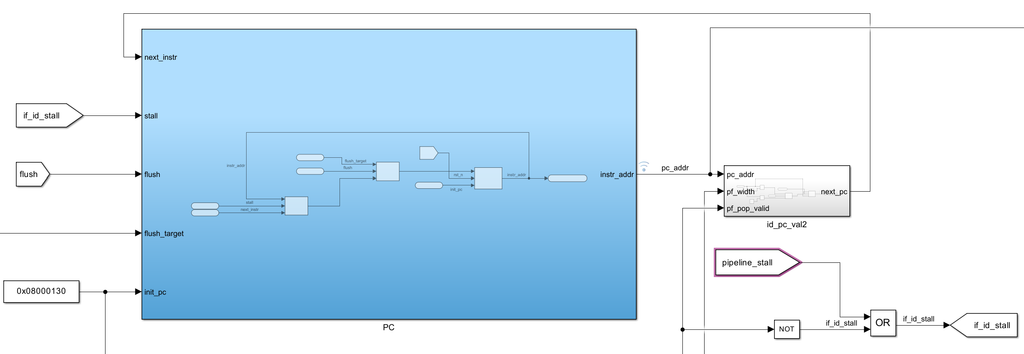
如图所示为 PC(程序计数器)模块的 Simulink 模型。该模块主要负责计算并输出当前正在取指的指令地址(pc_addr / instr_addr),其核心控制逻辑包括:
- 地址更新与多路选择:PC 内部包含多路选择器,正常情况下根据指令宽度(16位或32位)计算递增地址;当遇到流水线冲刷时,则装载外部传入的重定向地址。
- 优先级控制输入:包含复位/初始化地址(init_pc,如图中固定为 0x08000130)、流水线停顿信号(stall)、冲刷使能信号(flush)以及冲刷目标地址(flush_target)。当 flush 有效时,其优先级最高,直接更新 PC。
- 流水线时序控制:模型右侧附带了一个触发器和组合逻辑网络,用于生成 if_id_stall(IF/ID 阶段停顿信号),并配合下一级模块将当前 PC 值、指令宽度(pf_width)等信息锁存打拍,确保三级流水线的时序对齐。
3.2 ID
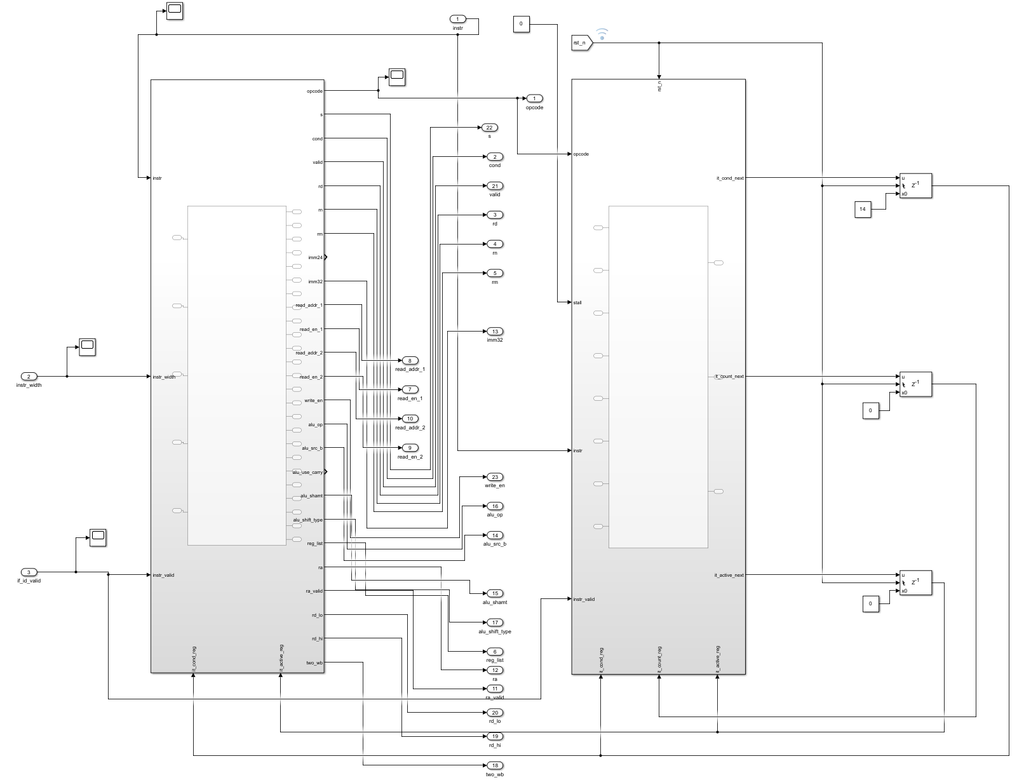
整体模型图中的黄色模块为 ID 指令译码器模块,它是连接取指(IF)与执行(EX)阶段的桥梁。如图所示,该模块主要由两个核心子模块级联构成:
ID_Comb(组合逻辑译码器):负责接收输入的 32 位机器码,通过内部的大型组合逻辑阵列(或 Matlab Function)提取指令特征,解析出操作码(opcode)、ALU 操作码(alu_op)、立即数,以及初步的寄存器读写地址。
IT 状态机模块(右侧蓝色框):这是针对 ARMv7-M(Cortex-M3)架构 Thumb-2 指令集特有设计的模块。它专门用于处理 IT(If-Then)条件执行指令块。该状态机能够跟踪当前的 IT 条件状态,并输出条件码信号。
信号掩码与最终输出:模型右侧的多路选择器(MUX)网络,将 ID_Comb 解析出的初步信号与 IT 状态机输出的条件信号结合,对寄存器索引进行最终的条件匹配与掩码控制,从而生成供寄存器堆(RF)和控制单元使用的最终读写地址及使能信号。
3.3 寄存器文件(RF-Register File)
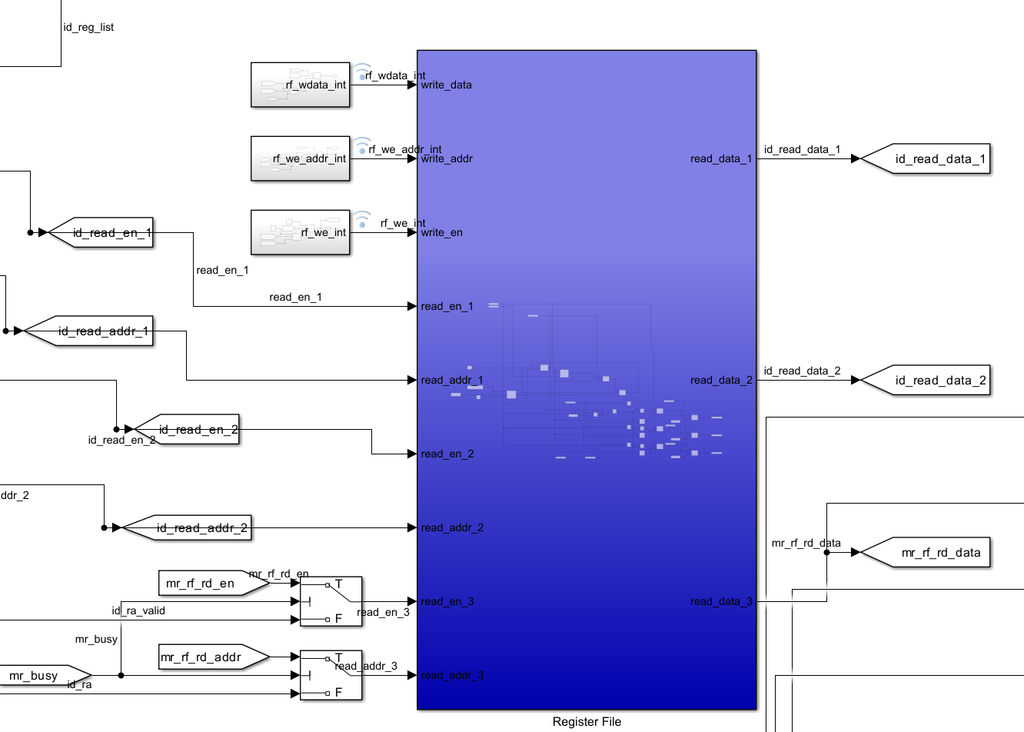
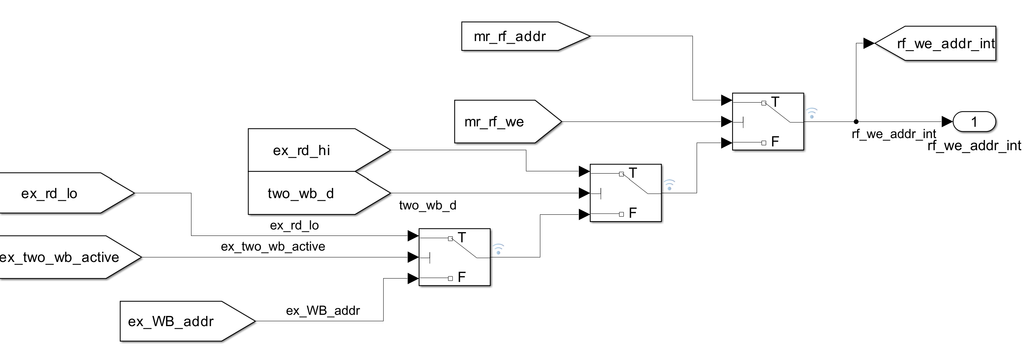
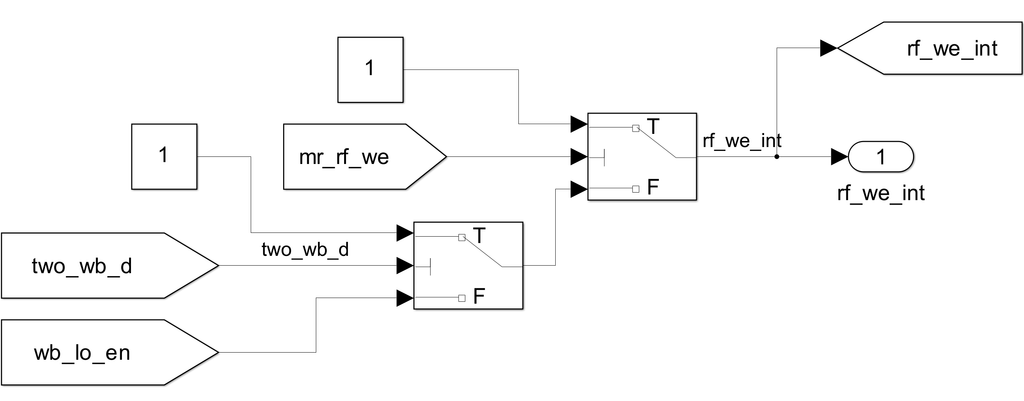
如图是位于ID阶段的寄存器文件,从图中能够看到其有三个读口和一个写口,每个口对应三个端口包括使能、地址和数据,总共12个端口。读口1和2直接来自于ID模块,读口3还可能来自于EX阶段的MR状态机,因为MR状态机可能会多周期读写寄存器。输出端口三是使用分支直接连接MR状态机,能够保证MR在同一个周期之内读取指令并写入内存。
3.4 ALU
ALU整体由一个Multiport Switch和多个算数逻辑标准块组成,根据输入的数据alu_a、alu_b、alu_shamt等参数以及操作数alu_op计算和筛选得到目标值,再输出结果alu_result。同时也包括输出alu_c、alu_v、alu_n、alu_z标志位给APSR或者前递给ID阶段。
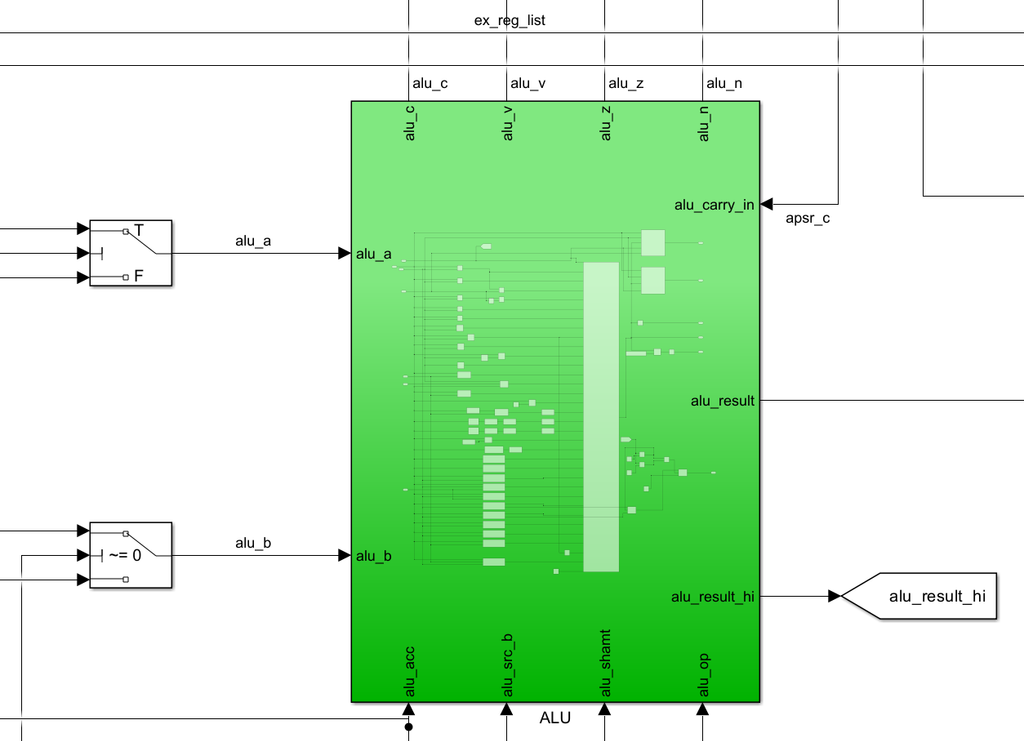
对于ARM架构中需要将寄存器操作数先移位、再参与ALU运算的指令,比如ADD Rd, Rn, Rm, LSL #n。alu_b输入端口前的alu_b_shift_unit模块能够将输入的B数据进行预移位,再输入进入ALU进行计算,核心包含移位类指令以及移位寻址指令两大类。
3.5 程序状态寄存器(APSR-Application Program Status Register)
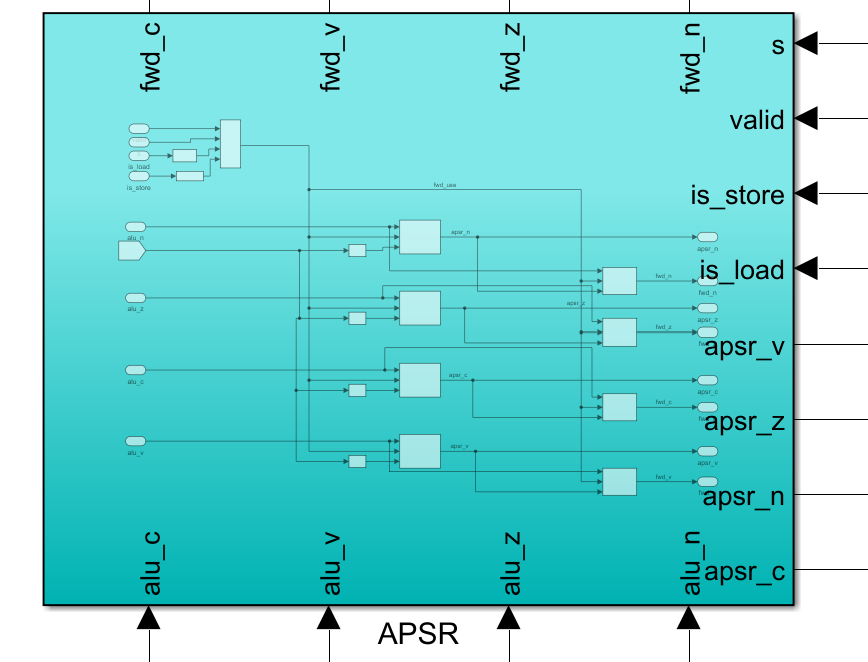
APSR模块主要负责程序状态标志位(N、Z、C、V)的暂存、更新与前递,是实现指令条件执行和分支裁决的核心。在硬件实现上,该模块通过内部的多路选择器(MUX)网络和使能控制信号(如 s、valid)进行条件写入:当指令带有状态更新需求时,将 ALU 计算产生的最新标志位(alu_c、alu_v、alu_z、alu_n)锁存;否则保持原状态不变。此外,针对流水线中的数据依赖及多周期访存场景(由 is_load、is_store 信号指示),模块内部集成了标志位旁路逻辑,能够接收并处理前递信号(fwd_c、fwd_v、fwd_z、fwd_n)。最终,模块输出两套信号:一套作为稳定的架构状态(apsr_*)送往分支单元(Branch Unit)用于条件跳转的早期裁决;另一套作为最新的前递信号(fwd_*)配合前递单元处理数据相关,从而有效避免因标志位未及时更新而引发的流水线停顿。
3.6 内存单元(Memory)
本流水线面向指令宽度和地址宽度均为 32 位的 CPU。若按字节编址,则 CPU 最大可寻址空间为。存储器采用统一编址方式,通过地址域(高位地址译码/片选)将 4GB 地址空间中的不同区间映射到 Flash 和 SRAM。
Flash区域用于存放程序代码和只读常量,CPU 取指及常量加载访问此区域。SRAM 则映射在另一指定地址段(具体范围需由存储设计给出),用于存放数据、栈和堆,支持读写访问。
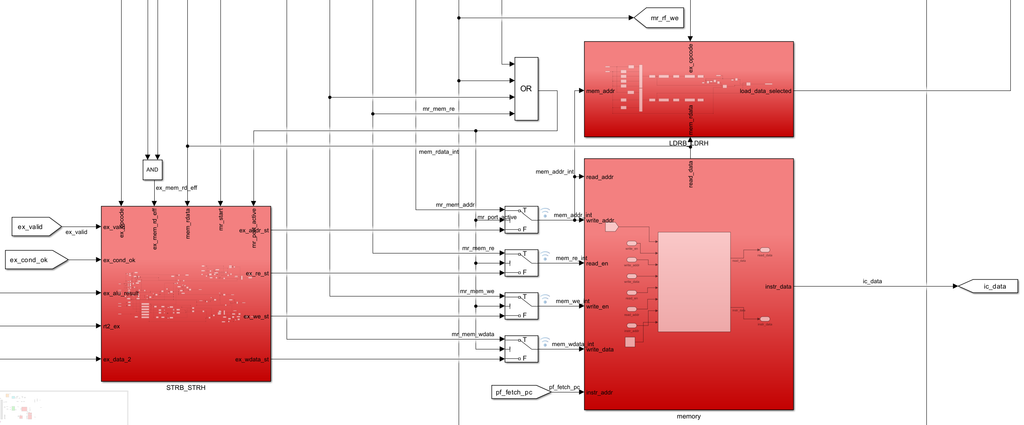
另外,STR指令类型中存在部分写(如 STRB、STRH),需要使用“读-改-写”(Read-Modify-Write)机制。通过提取目标地址的低位计算移位量,结合动态生成的掩码(Mask)对原内存数据进行保护,再将移位对齐后的新数据与原数据进行合并,最终写回内存。
在加载(Load)类指令的处理中,由于内存返回的是 32 位对齐的数据,LDRB和LDRH模块采用组合逻辑实现了精准的数据截取与扩展。首先,模块利用访存地址mem_addr的低位作为多路选择器(Mux)的控制信号,从返回的mem_rdata中分别切分出目标字节(byte0~byte3)或半字(half_lo\half_hi)。其次,为了兼容带符号与无符号加载指令,设计了双通路扩展逻辑:零扩展路径直接高位补零,而符号扩展路径则利用“逻辑左移(将符号位推至最高位)+ 算术右移(高位用符号位填充)”的纯移位操作高效完成。最后,模块通过比较器对指令操作码(ex_opcode)进行译码,识别当前加载指令的具体变体(如判定是否为带符号加载),并通过多级 Mux 选择输出最终的load_data_selected;若为普通的 32 位字加载(LDR),则直接透传原始内存数据,从而完整覆盖了 ARM 架构下的各类访存加载需求。
3.7 MR
MR状态机用于执行多周期指令,一方面需要将流水线Stall,另一方面要执行Load或者Store指令,访问寄存器RF和内存模块Memory。
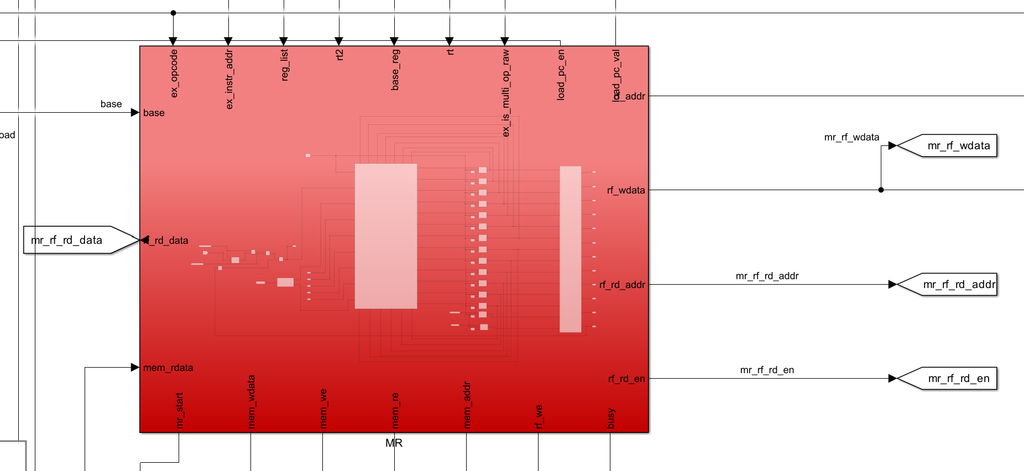
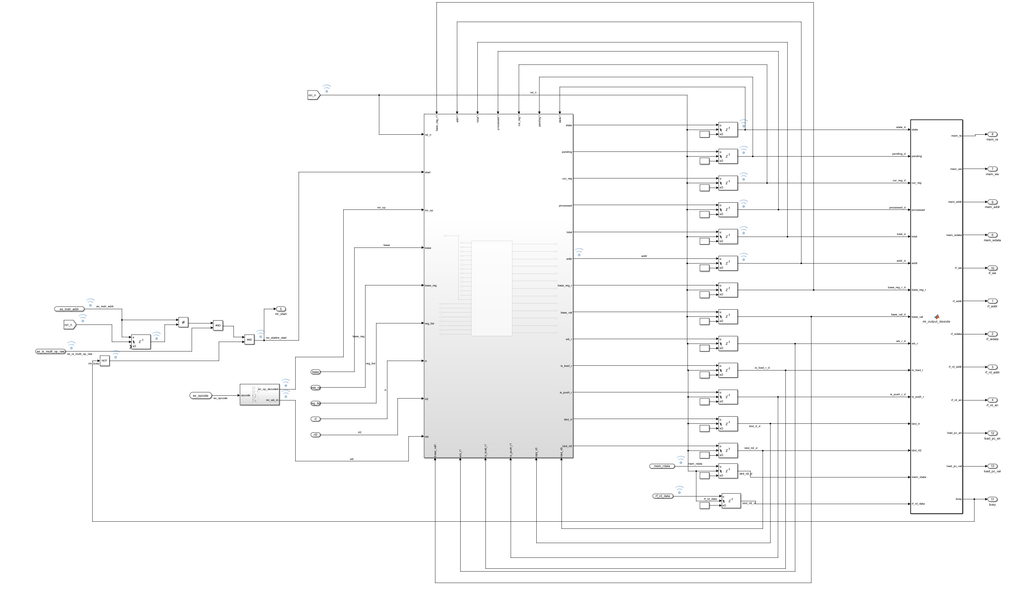
MR在设计的过程中要注意,当两个连续的多周期指令到来,需要用比较器区分两个指令的地址,确保start信号能够被再次激活。
3.8 Branch Unit
本设计使用了类似于早期分支(Early Branch)的分支目标转发功能,在分支类指令还在ID阶段的时候就进行对跳跃目标的裁决,此时 IF 阶段已经预取了 1条错误的指令,流水线会flush的寄存器包括IF\ID、PC、Prefetch Unit。惩罚周期为3个周期,包括访存、装填FIFO、恢复过程。
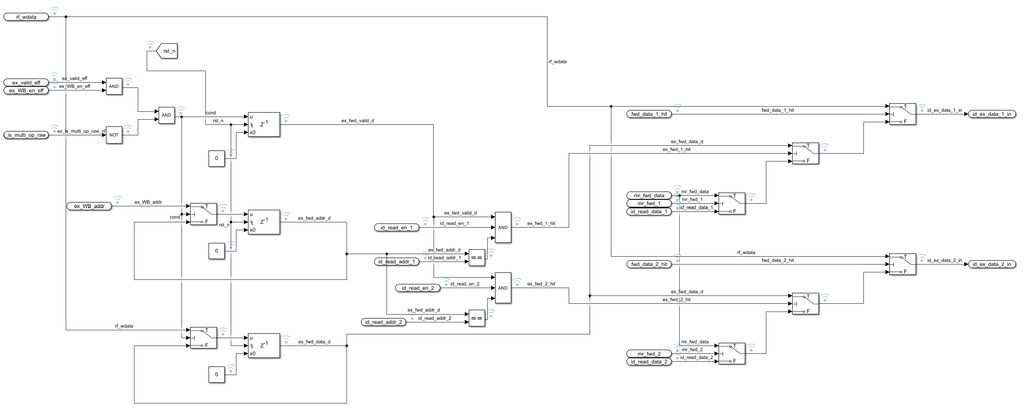
3.9 Forward Unit
通过Switch逻辑区分不同数据源前递的冲突,优先级:EX same-cycle>EX delayed > MR multi-cycle
3.10 Prefetch Unit
4 仿真结果
CPU启动之后会进行初始化,初始化过程包括了MSP(主堆栈指针)初始化、分散加载(Scatter Loading)与内存初始化、Reset_Handler引导、栈堆分配与 C 库初始化等。初始化完成之后程序会从0x080003ae进入main函数,在main函数中通过BL指令跳转到对应函数入口地址,进入函数之后会通过Push指令将跳转前的地址记入栈,用于在函数结束时跳回。
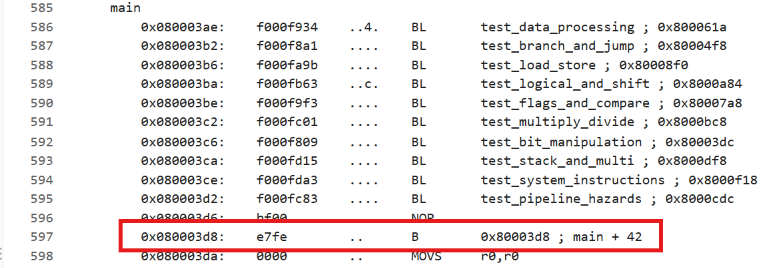
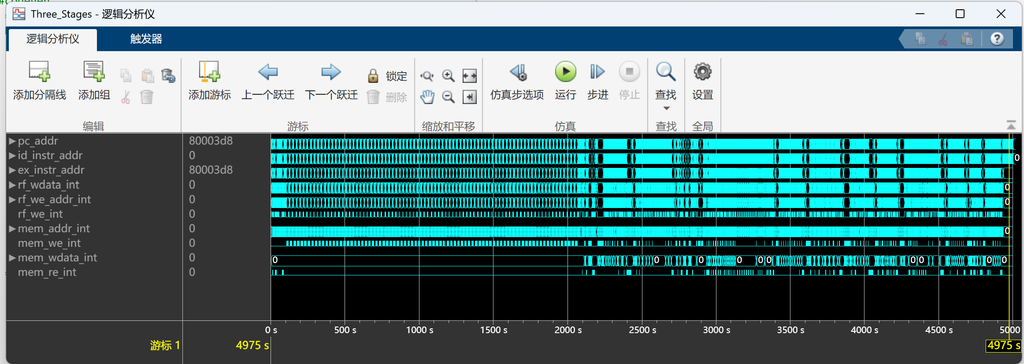
通过逻辑分析仪能够看到,地址指令最终能够走到while(1),也就是0x080003b6的位置,然后一直循环。这意味着CPU已经能够彻底跑通指令内容。控制链路验证完毕。
之后是验证CPU的数据链路是否正确。因为在C语言代码设计的时候就已经考虑到了结果验证问题,我在每个测试程序后面都加入了自评函数REC,自评函数能够比较理论值和实际处理器运行结果,对0x2XXXXXXX空间赋值,处理结果正确,赋值1,否则赋值0。通过查看Memory中对应的空间的值实现结果检验。
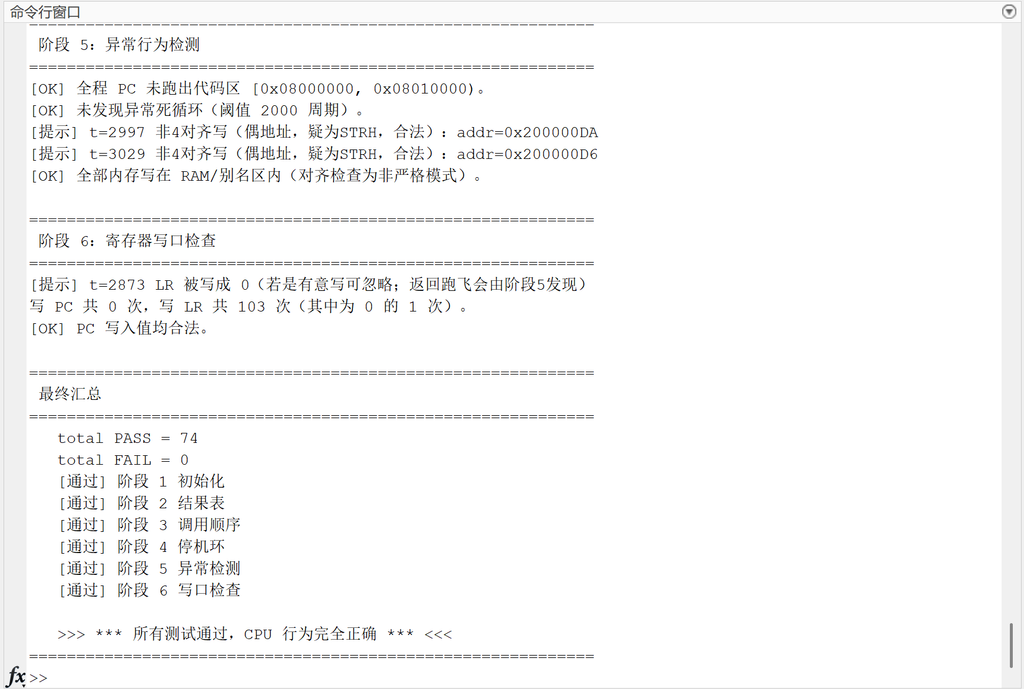
至此本CPU的验证全部通过。
